Funciones gráficas
Esta página documenta las funciones gráficas disponibles en la página Validación del modelo. Cada gráfico observa la comparación entre modelo y medidas desde un ángulo distinto — acuerdo punto‑a‑punto, distribuciones, evolución temporal, ciclos, síntesis multimétrica y estructura espacial — porque ningún índice ni gráfico por sí solo basta para juzgar la bondad de un modelo de calidad del aire. De cada función se describe qué muestra, cómo está construida (y a partir de qué datos) y los motivos que nos llevaron a introducirla.
🕒 = la función descarga datos brutos del servidor (carga por ventanas con barra de avance); las demás usan los datos resumidos ya precalculados en los datos de validación / los percentiles, de modo que son inmediatas. 🕒🕒 = procesamiento pesado no optimizable: la espera puede llegar a algunos minutos. Todos los gráficos cartesianos disponen de una barra de herramientas para exportar a CSV y a imagen (SVG/PNG), y para el zoom y su restablecimiento.
Acuerdo y bondad del modelo
Gráficos que comparan directamente el modelo y las observaciones para cuantificar la correlación, el sesgo (error sistemático) y la dispersión (error aleatorio).
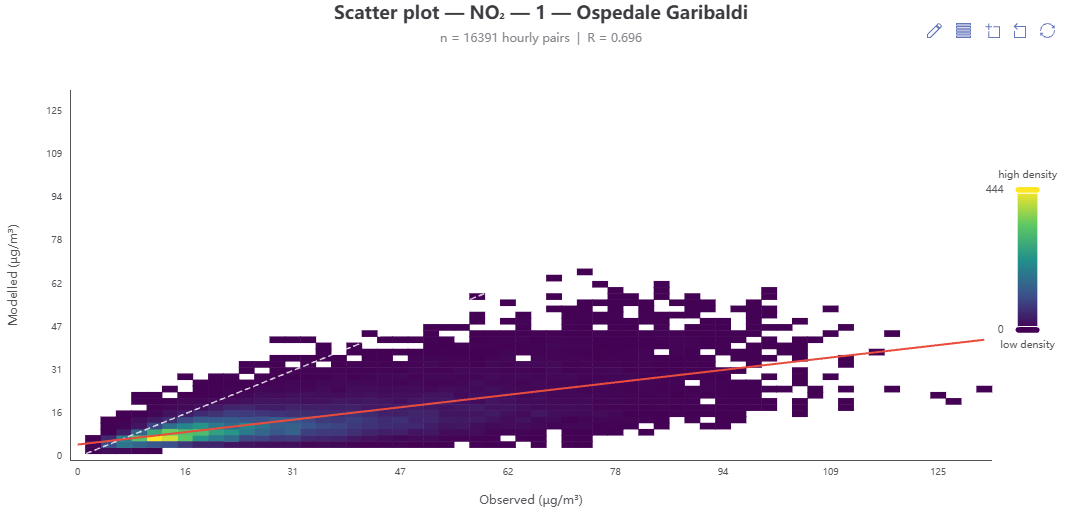
Gráfico de dispersión modelo frente a observado 🕒 datos del servidor
Qué muestra. La nube de los pares horarios (observado en el eje X, modelado en el eje Y). Con muchos miles de puntos, la nube se dibuja como mapa de calor de densidad en una retícula de 60×60; se superponen la recta 1:1 (acuerdo perfecto) y la recta de regresión.
Cómo se construye. Los pares se descargan vía scatter_data (intersección temporal entre las medidas de la estación y los valores del modelo en la celda correspondiente, filtrable por año/estación/mes). La pendiente, la ordenada en el origen y R proceden de los datos de validación (registro «global»).
Por qué lo usamos. Es la comparación punto‑a‑punto fundamental: muestra la dispersión, el eventual sesgo sistemático (desviación respecto de la 1:1) y las no linealidades de la respuesta del modelo.
Sesgo condicionado a la concentración 🕒 datos del servidor
Qué muestra. El valor medio del modelo para cada clase de concentración observada, con una banda de dispersión (IQR P25–P75 o bien P10–P90), comparado con la recta 1:1.
Cómo se construye. Los pares obs/mod (scatter_data) se agrupan en clases por concentración observada (por cuantiles, es decir con igual número de datos, o bien con igual anchura); para cada clase se calculan la media observada (abscisa) y la media/mediana y los percentiles del modelo.
Por qué lo usamos. La dispersión global esconde dónde se equivoca el modelo: este gráfico aísla el sesgo en función del nivel, y hace evidente la típica subestimación de los picos — información crucial para las superaciones y los efectos sanitarios.
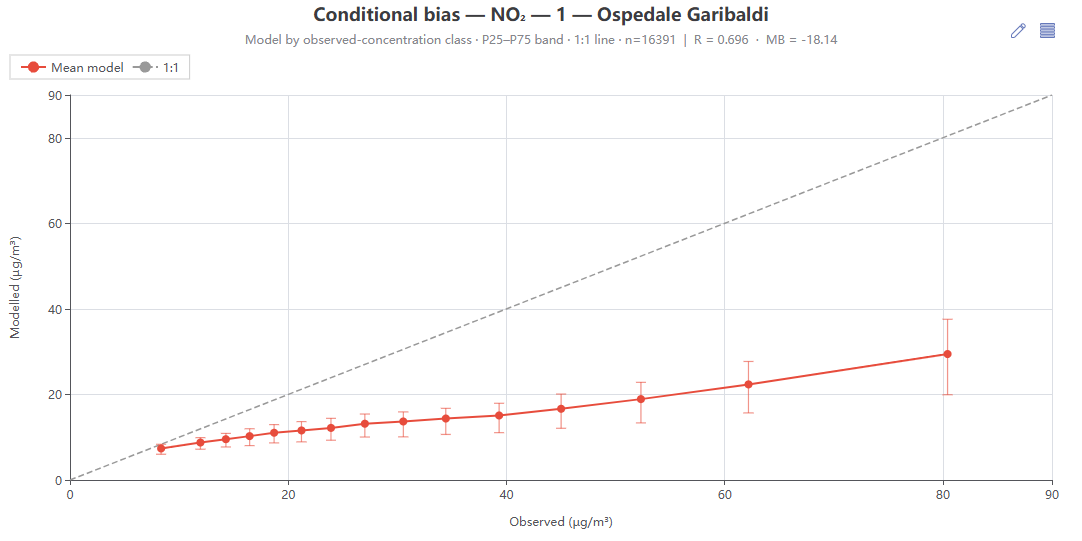
Gráfico Q-Q
Qué muestra. Los cuantiles observados frente a los modelados (P10…P99) para cada contaminante, con la recta 1:1.
Cómo se construye. A partir de los percentiles precalculados (estratificación «global»), fuentes measured y model.
Por qué lo usamos. Compara las distribuciones con independencia del emparejamiento temporal; es especialmente sensible a los desacuerdos en las colas (valores extremos).
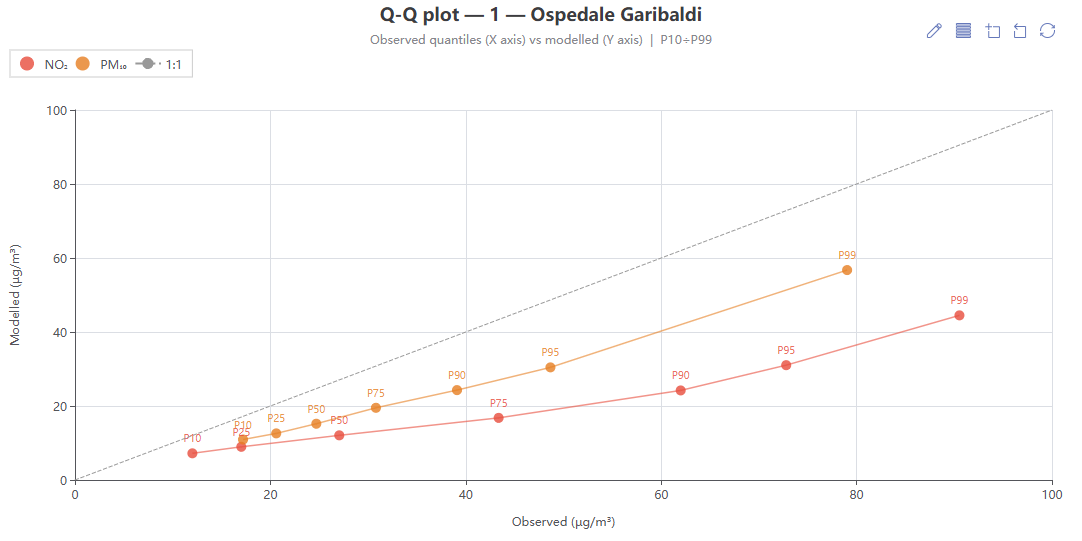
Diagrama de Taylor
Qué muestra. En un solo punto por estación×contaminante: la correlación (ángulo), la razón entre desviaciones típicas σ_mod/σ_obs (radio) y el RMSE normalizado (arcos centrados en el punto «observaciones»).
Cómo se construye. A partir de los datos de validación (global): r, std_obs, std_mod; el RMSE normalizado es √(1 + σ² − 2σR), con σ = σ_mod/σ_obs.
Por qué lo usamos. Una sola figura resume el error de fase (R) y el de amplitud (σ): es el estándar para comparar muchas series a la vez.
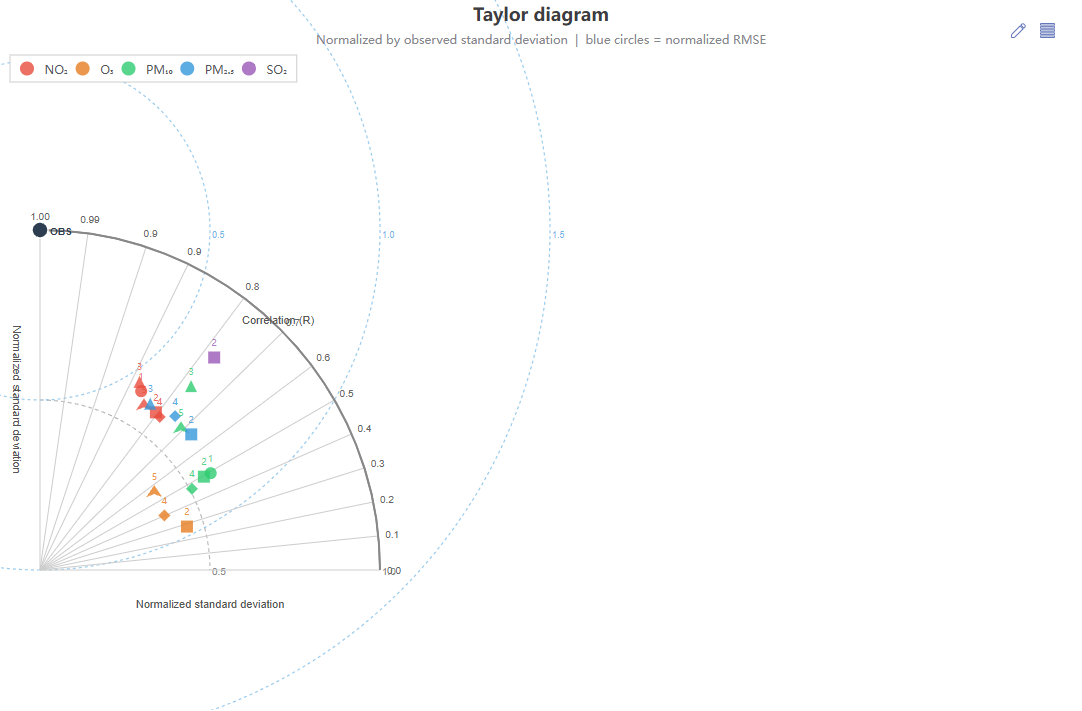
Diagrama de Taylor animado (mes) 🎞️ animación
Qué muestra. El mismo diagrama de Taylor, pero animado en el tiempo: cada fotograma es un mes (1–12) y cada estación es un punto que se desplaza de mes en mes. La barra temporal de abajo permite la reproducción automática, la pausa y la selección manual del mes; un selector ajusta la velocidad y la leyenda permite encender y apagar cada estación.
Cómo se construye. A partir de los datos de validación con estratificación «mes» (r, std_obs, std_mod para cada mes): el fondo del diagrama (arcos de desviación típica, arcos de RMSE, radios de correlación) es fijo, mientras que los puntos se actualizan fotograma a fotograma. La escala radial se calcula sobre todos los meses, así el diagrama no «salta» durante la animación.
Por qué lo usamos. El Taylor estático promedia todo el periodo: la animación revela la evolución estacional del rendimiento — meses en los que el modelo pierde correlación o amplifica/atenúa la variabilidad — y hace inmediatas las comparaciones entre estaciones a lo largo del año.

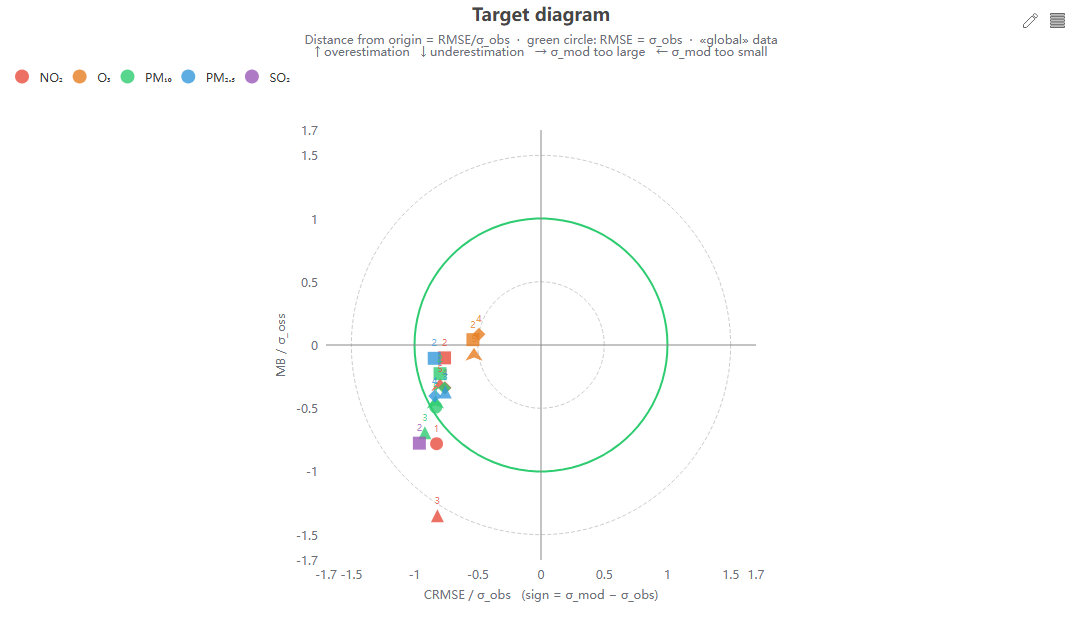
Diagrama target
Qué muestra. El sesgo normalizado (Y) frente al error centrado normalizado con signo (X); la distancia al origen es RMSE/σ_obs y el círculo verde (radio 1) indica un error igual a la variabilidad observada.
Cómo se construye. Variante de Jolliff: a partir de mb, crmse, std_obs, std_mod — X = sign(σ_mod − σ_obs)·CRMSE/σ_obs, Y = MB/σ_obs (se cumple RMSE² = MB² + CRMSE²). La normalización se hace sobre σ_obs porque no disponemos de la incertidumbre de medida que exige el MQI de FAIRMODE.
Por qué lo usamos. Clasifica de un vistazo tanto la calidad (cercanía al origen) como el tipo de error: el cuadrante indica sobrestimación/subestimación y variabilidad excesiva/insuficiente.
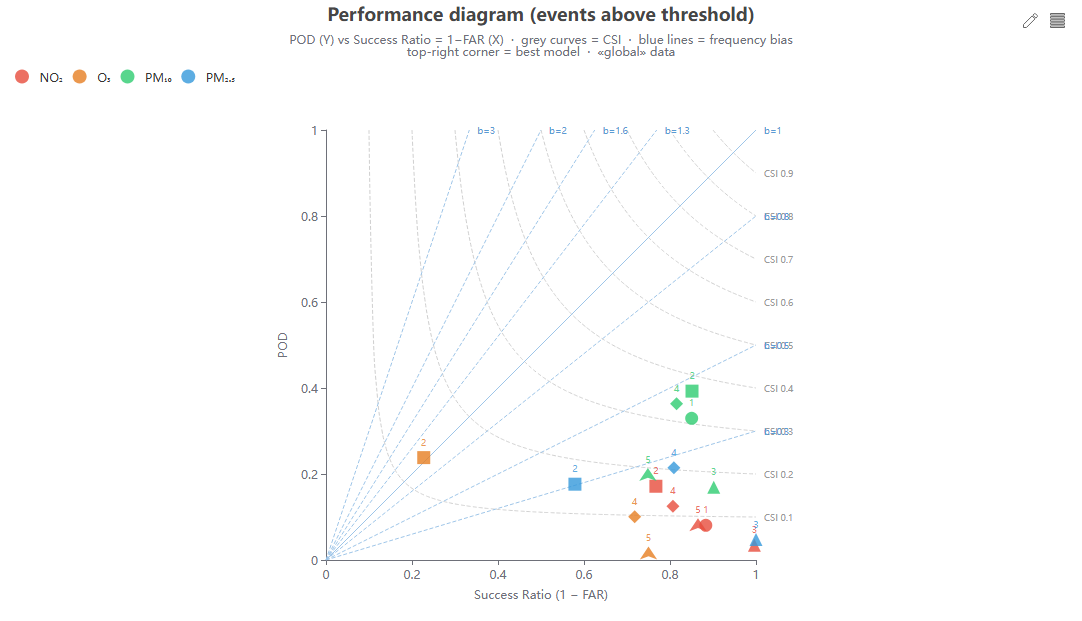
Performance diagram
Qué muestra. Para los eventos por encima del umbral: POD (probabilidad de detección) frente a Success Ratio (1−FAR), con curvas de CSI y rectas de frequency bias al fondo. La esquina superior derecha es el modelo perfecto.
Cómo se construye. A partir de pod/far en los datos de validación (el umbral del evento está predefinido). Las curvas de CSI y las rectas de sesgo se trazan analíticamente.
Por qué lo usamos. Las métricas continuas no captan la capacidad de prever las superaciones: aquí se equilibran las alarmas falladas y las falsas alarmas, aspecto central para la salud pública.
Dispersión σ-ratio frente a R
Qué muestra. Para una estación, cada contaminante como punto de coordenadas (R, σ_mod/σ_obs), con las líneas ideales R = 1 y stdRatio = 1.
Cómo se construye. A partir de los datos de validación (global).
Por qué lo usamos. Separa visualmente el error de fase (R bajo) del error de amplitud (stdRatio distinto de 1), orientando el diagnóstico de las causas.
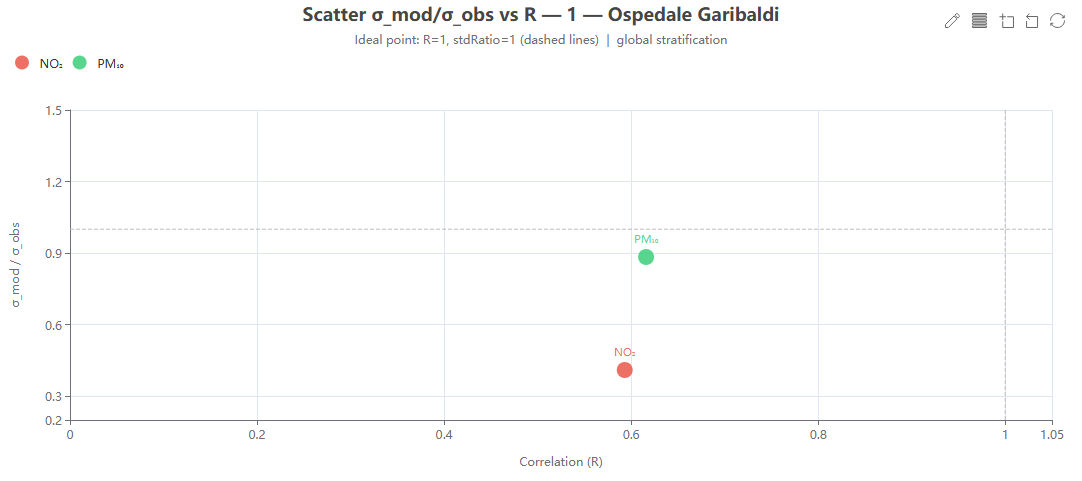
Diagrama de Taylor 3D — estación del año (eje Z)
Qué muestra. El diagrama de Taylor extendido a una tercera dimensión: cada nivel del eje Z es una estación del año, de modo que se ve cómo cambia el acuerdo a lo largo del año.
Cómo se construye. Los mismos ingredientes del Taylor (r, σ_mod, σ_obs) pero extraídos por estratificación «season»; los arcos de referencia se replican en cada nivel (dibujo con ECharts GL).
Por qué lo usamos. Identifica las estaciones en las que el modelo empeora (p. ej. inversiones invernales, fotoquímica estival).

Diagrama de Taylor 3D — contaminante (eje Z)
Qué muestra. Como el anterior, pero el eje Z recorre los contaminantes: compara en un único espacio la bondad del modelo para las distintas especies.
Cómo se construye. A partir de los datos de validación (global), un plano de Taylor por contaminante.
Por qué lo usamos. Pone en fila los puntos fuertes y débiles del modelo para cada contaminante.

Diagrama de Taylor 3D — hora del día (eje Z)
Qué muestra. El diagrama de Taylor con la hora del día en el eje Z: cómo varía el acuerdo a lo largo de las 24 horas.
Cómo se construye. A partir de los datos de validación (estratificación «hour»).
Por qué lo usamos. Revela las franjas horarias críticas (horas punta del tráfico, pico fotoquímico de la tarde).

Evolución temporal
Gráficos que siguen la evolución en el tiempo de las medidas y del modelo, desde los episodios concretos hasta los ciclos recurrentes.
Serie temporal modelo frente a observado 🕒 datos del servidor
Qué muestra. Las dos series (medido y modelo) superpuestas en el tiempo, con agregación seleccionable (diaria, media móvil de 7 o 30 días, mensual) y una banda de residuos (modelo − observado) opcional.
Cómo se construye. A partir de las medias diarias obs/mod (calendar_data); la agregación y los residuos se calculan del lado del cliente sobre los días en caché. R, MB y RMSE globales aparecen en el subtítulo.
Por qué lo usamos. Es el diagnóstico más inmediato y cubría una laguna evidente: hace visibles los episodios, las derivas estacionales y los periodos anómalos que las métricas agregadas esconden.

Ciclo diurno
Qué muestra. El ciclo medio diario (mediana horaria P50) de lo medido (línea continua) y del modelo (discontinua), para cada contaminante presente.
Cómo se construye. A partir de los percentiles (estratificación «hour»).
Por qué lo usamos. Comprueba la reproducción del ciclo diario (tráfico, fotoquímica) y pone de manifiesto los posibles desfases horarios.

Mapa de calor de calendario 🕒 datos del servidor
Qué muestra. Un calendario anual en el que cada día se colorea según la media diaria (medido, modelo o sesgo modelo − medido).
Cómo se construye. A partir de calendar_data (medias diarias obs/mod).
Por qué lo usamos. Ofrece una vista de conjunto de la estacionalidad, los episodios agudos y las lagunas en los datos, difícil de captar en una serie continua.
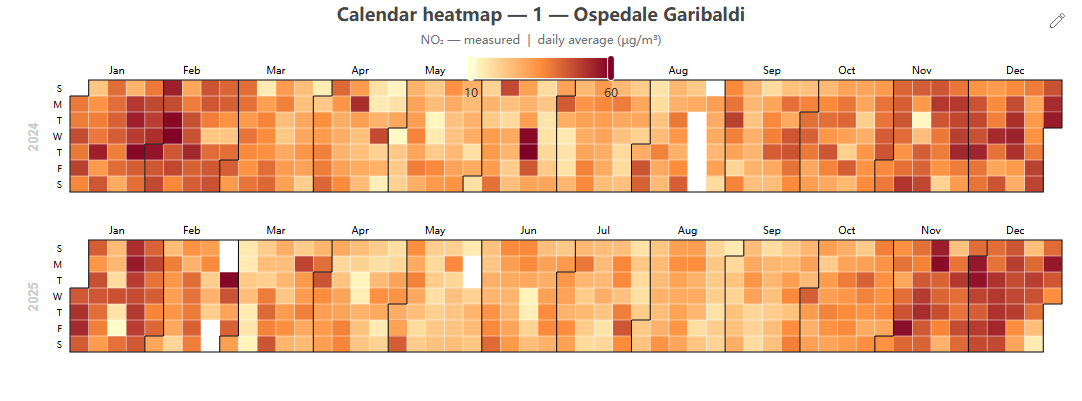
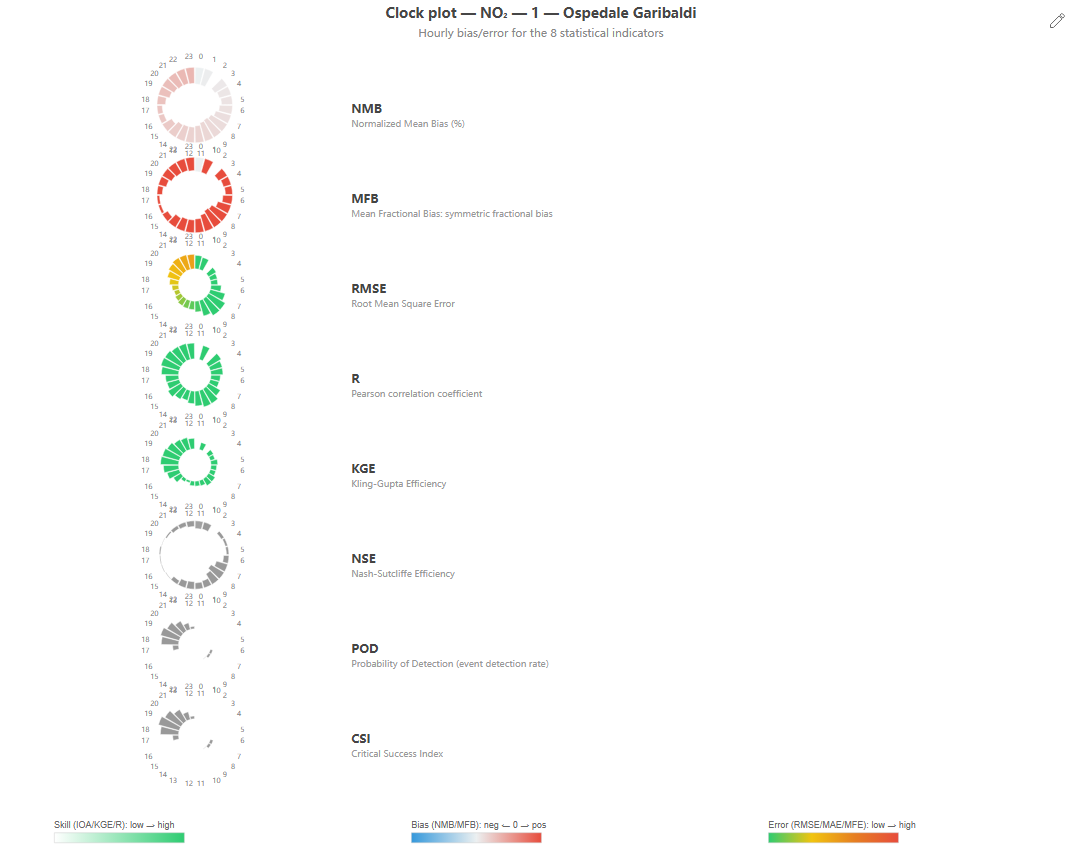
Gráfico de reloj del sesgo diario
Qué muestra. Un indicador elegido dispuesto en una esfera de 24 horas (las horas en círculo), para leer la variación de la métrica a lo largo del día.
Cómo se construye. A partir de los datos de validación (estratificación «hour»), con escala divergente para las métricas de sesgo.
Por qué lo usamos. Destaca de forma compacta e intuitiva las horas del día en las que la métrica (p. ej. el sesgo) se concentra.
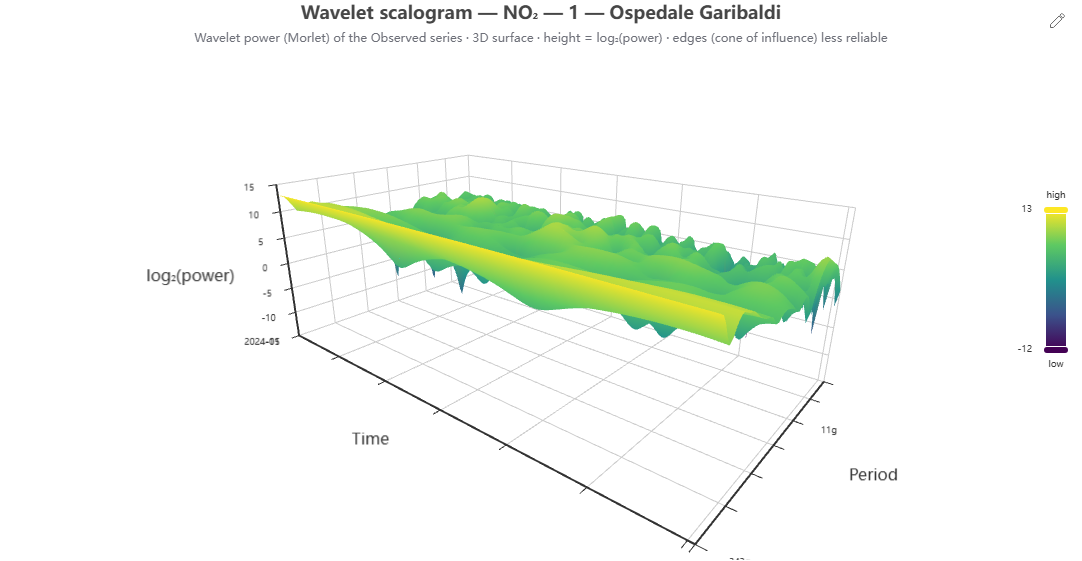
Escalograma wavelet 🕒 datos del servidor
Qué muestra. La potencia wavelet (Morlet) de la serie elegida (observado o modelo) en el plano tiempo×periodo: dónde y cuándo una periodicidad (diaria, semanal, mensual…) es más intensa. El área fuera del cono de influencia no se muestra.
Cómo se construye. La serie diaria u horaria (selector de resolución) se descarga vía calendar_data/series_hourly; la transformada wavelet continua de Morlet se calcula del lado del cliente (FFT), con potencia |W|² en escala logarítmica (log₂). Las columnas se submuestrean para el dibujo.
Por qué lo usamos. A diferencia de un ciclo medio, localiza en el tiempo la intensidad de las periodicidades y muestra su no‑estacionariedad (p. ej. ciclo diurno más marcado en verano, episodios).
Vista 2D/3D. Un selector permite pasar del mapa de calor 2D a la superficie 3D interactiva (altura = log₂ de la potencia), que hace resaltar las crestas de las periodicidades dominantes y su evolución en el tiempo. En la vista 3D la superficie incluye también el cono de influencia (bordes menos fiables) y el tiempo se submuestrea más finamente para que siga siendo fluida.
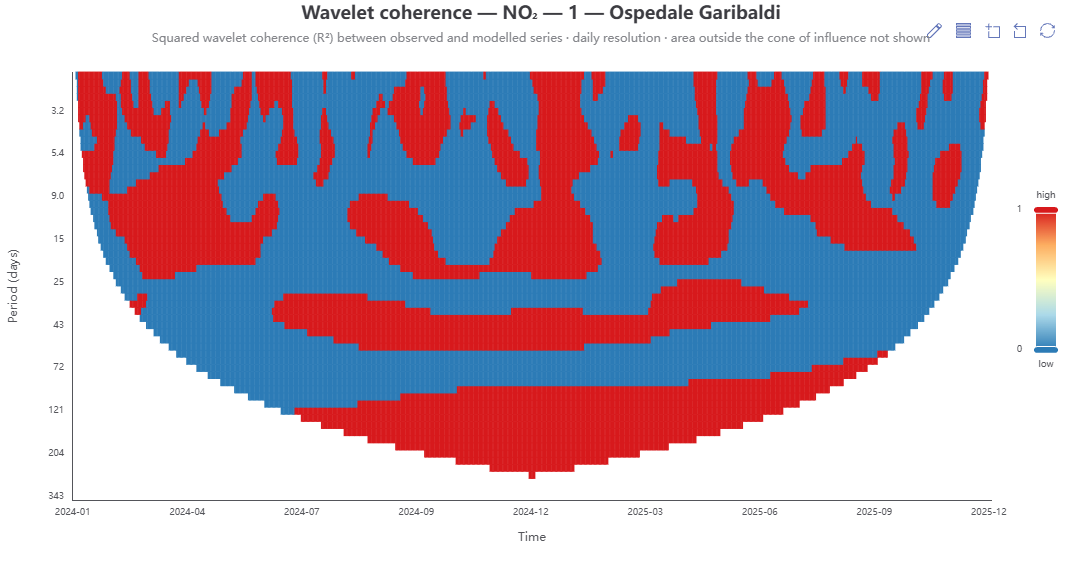
Coherencia wavelet observado↔modelo 🕒 datos del servidor
Qué muestra. La coherencia wavelet al cuadrado R² (tiempo, periodo), comprendida entre 0 y 1, entre observado y modelo: en qué escalas temporales y en qué periodos reproduce el modelo la estructura cíclica de las observaciones.
Cómo se construye. Transformadas wavelet de observado y modelo sobre la misma retícula diaria, espectro cruzado suavizado en el tiempo y en la escala (Torrence & Webster 1999); el área fuera del cono de influencia no se muestra.
Por qué lo usamos. Diagnóstico de validación más allá de la correlación global: indica si el modelo capta el ciclo diurno/semanal y dónde pierde coherencia.
Descomposición STL (tendencia / estacionalidad / residuo)
Qué muestra. La descomposición STL de la serie diaria en cuatro paneles alineados (serie, tendencia, estacionalidad, residuo), con observado y modelo superpuestos y conmutables desde la leyenda; el zoom temporal está sincronizado entre los paneles.
Cómo se construye. Lee la STL precalculada (statsmodels, periodo semanal) a través del punto de acceso stl_data.
Por qué lo usamos. Separa la evolución de fondo (tendencia), el ciclo (estacionalidad) y las anomalías (residuo, p. ej. episodios del Etna), y compara directamente las tres componentes de observado y modelo.

Ciclos hora × estación del año
Mapas de calor y gráficos de reloj que cruzan la hora del día con el mes o la estación del año, para leer los patrones periódicos combinados.
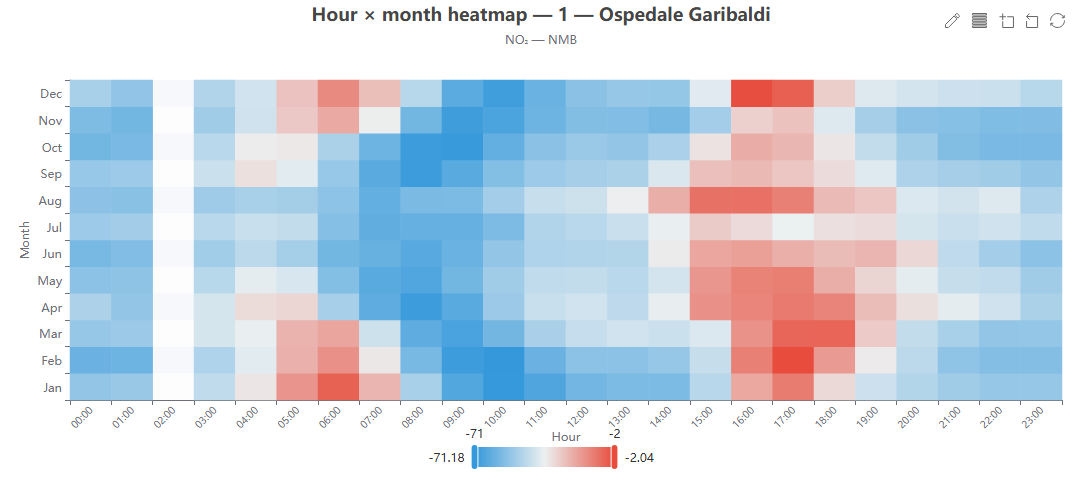
Mapa de calor hora × mes (plano)
Qué muestra. Una retícula de 24 horas × 12 meses coloreada según la métrica elegida (o según la concentración bruta mediana).
Cómo se construye. A partir de los datos de validación o de los percentiles (estratificación «hour_month»).
Por qué lo usamos. Revela patrones combinados hora–estación del año, como los picos vespertinos estivales de ozono.
Mapa de calor hora × mes (cilindro)
Qué muestra. La misma información envuelta en un cilindro 3D: el ángulo es la hora, la altura el mes.
Cómo se construye. Los mismos datos de la versión plana, proyectados sobre una superficie cilíndrica (ECharts GL).
Por qué lo usamos. La forma cilíndrica elimina la discontinuidad artificial entre la hora 23 y la hora 0, y devuelve la verdadera periodicidad diaria.

Mapa de calor estación × hora (plano)
Qué muestra. Una retícula estación del año × hora coloreada según la métrica elegida o la concentración bruta.
Cómo se construye. A partir de los datos de validación / de los percentiles (estratificación «season_hour»).
Por qué lo usamos. Compara directamente el ciclo diurno entre las cuatro estaciones del año.

Mapa de calor estación × hora (cilindro)
Qué muestra. La versión cilíndrica 3D del mapa de calor estación del año × hora.
Cómo se construye. Los mismos datos «season_hour» sobre una superficie cilíndrica (ECharts GL).
Por qué lo usamos. Lectura continua del ciclo horario, sin el salto 23→0, para cada estación del año.

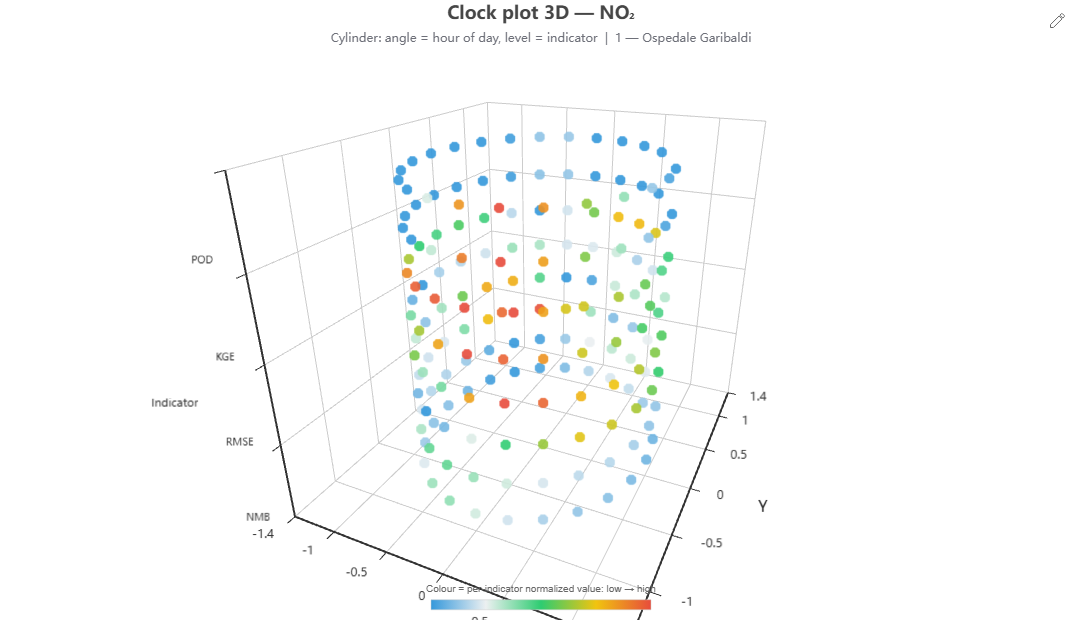
Gráfico de reloj 3D (cilindro)
Qué muestra. Un cilindro en el que el ángulo es la hora del día y los niveles del eje Z son los distintos indicadores, con los valores normalizados en color.
Cómo se construye. A partir de los datos de validación (estratificación «hour»); cada indicador se normaliza sobre su propio intervalo. Es posible la media de todas las estaciones.
Por qué lo usamos. Compara varios indicadores a lo largo del ciclo horario en una única figura.
Distribuciones
Gráficos que comparan la forma de las distribuciones de las medidas y del modelo, más allá de las solas medias.
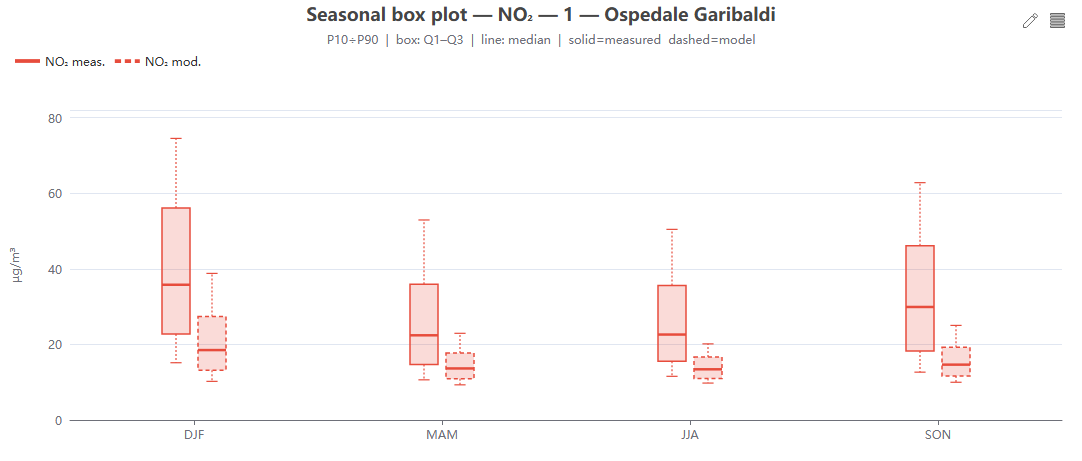
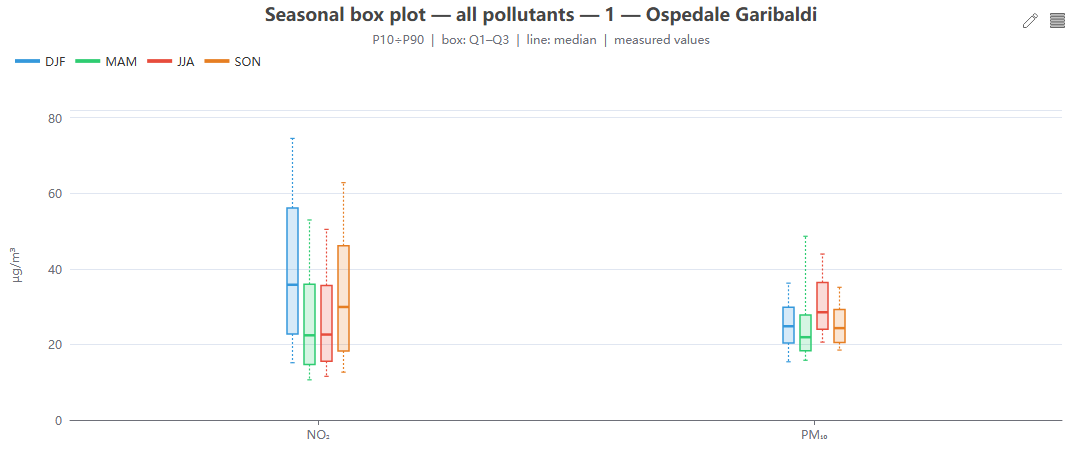
Diagramas de caja estacionales por contaminante
Qué muestra. Diagramas de caja estacionales (P10 – Q1 – mediana – Q3 – P90) para un único contaminante, con lo medido y el modelo uno al lado del otro; un selector cambia de contaminante.
Cómo se construye. A partir de los percentiles (estratificación «season»).
Por qué lo usamos. Compara la dispersión estacional, no solo los valores centrales, y muestra si el modelo comprime o ensancha la distribución.
Diagramas de caja estacionales de todos los contaminantes
Qué muestra. Los diagramas de caja estacionales de todos los contaminantes juntos, con un conmutador medido/modelo.
Cómo se construye. A partir de los percentiles (estratificación «season»).
Por qué lo usamos. Panorámica comparativa de la variabilidad entre las distintas especies.
Comparación de percentiles de pico (P90/P95/P99)
Qué muestra. Barras agrupadas de los percentiles altos (P90, P95, P99) observados y modelados para cada contaminante.
Cómo se construye. A partir de los percentiles (estratificación «global»).
Por qué lo usamos. Los percentiles altos gobiernan las superaciones normativas: aquí se comprueba si el modelo reproduce los niveles de pico.

Banda de percentiles mensual (P50 + P10–P90)
Qué muestra. Para cada mes del año (ene–dic) la mediana (P50) de observado y modelo, con la banda P10–P90 de lo observado: el nivel típico y la dispersión mensual comparados.
Cómo se construye. A partir de los percentiles mensuales (estratificación «month», fuentes «measured» y «model»).
Por qué lo usamos. Muestra la climatología mensual y comprueba si el modelo capta el nivel mediano y la amplitud de la variabilidad a lo largo del año.

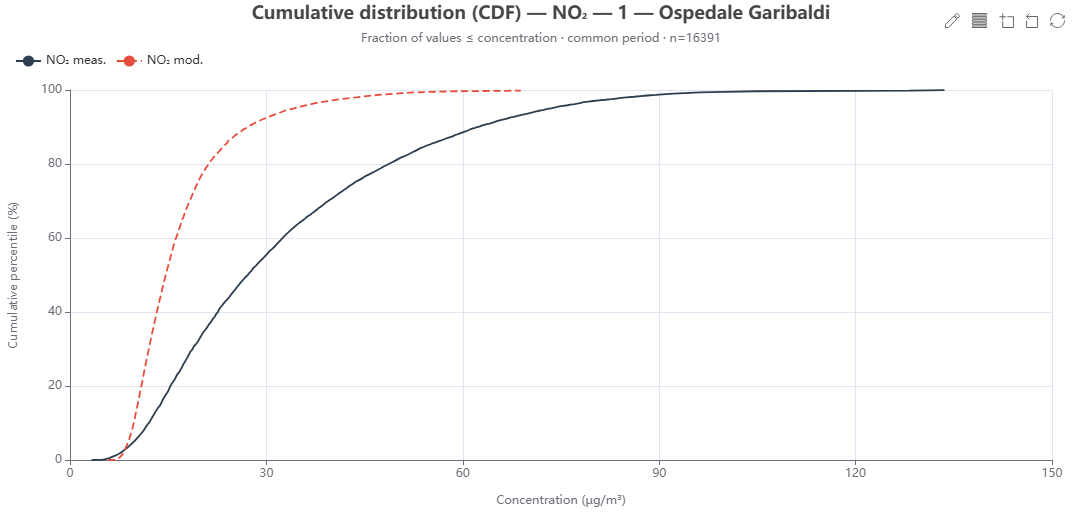
Curvas de distribución acumulada (CDF) 🕒 datos del servidor
Qué muestra. Las curvas acumuladas empíricas (ECDF) de observado y modelo en el periodo común: para cada concentración, la fracción de valores menores o iguales.
Cómo se construye. A partir de los pares de scatter_data; los valores se ordenan y se submuestrean por ligereza.
Por qué lo usamos. Comparación distributiva completa (no solo siete percentiles), complementaria del Q-Q y de los diagramas de caja.
Síntesis multimétrica
Gráficos que condensan varios índices en una única vista de conjunto.
Gráfico radar estacional
Qué muestra. Un radar por estación con los cuatro vértices = estaciones del año, que traza el valor de una métrica elegida; los contaminantes son series superpuestas.
Cómo se construye. A partir de los datos de validación (estratificación «season»).
Por qué lo usamos. Compara de un vistazo la métrica entre estaciones del año, contaminantes y estaciones de medida.
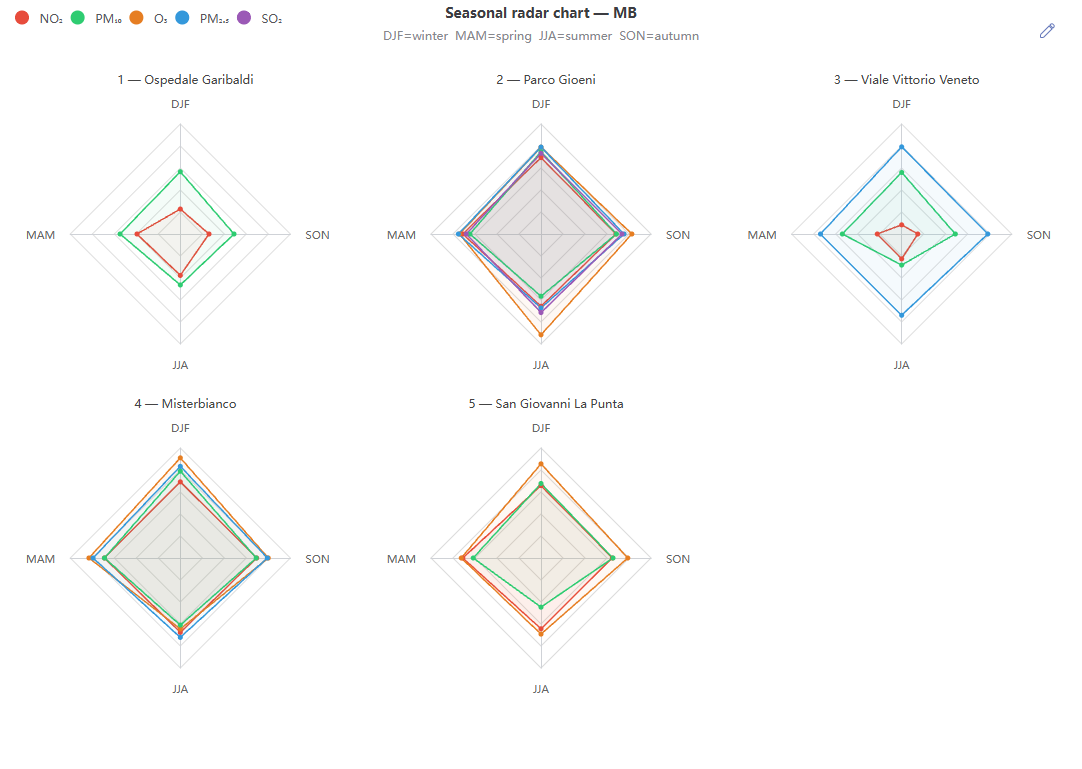
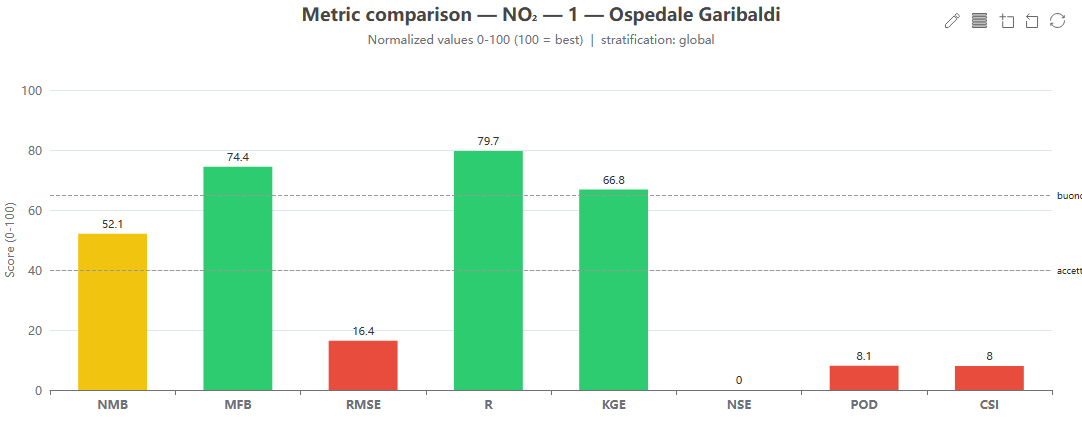
Gráfico de barras comparativo multimétrica
Qué muestra. Las barras de todas las métricas, normalizadas 0–100 (100 = óptimo) para un contaminante/estación, coloreadas por franja de calidad.
Cómo se construye. A partir de los valores brutos de validación normalizados con las mismas reglas de la puntuación; respeta la estratificación seleccionada (global/estación del año/hora).
Por qué lo usamos. Es un panel sintético de los puntos fuertes y débiles del modelo en una única escala comparable.
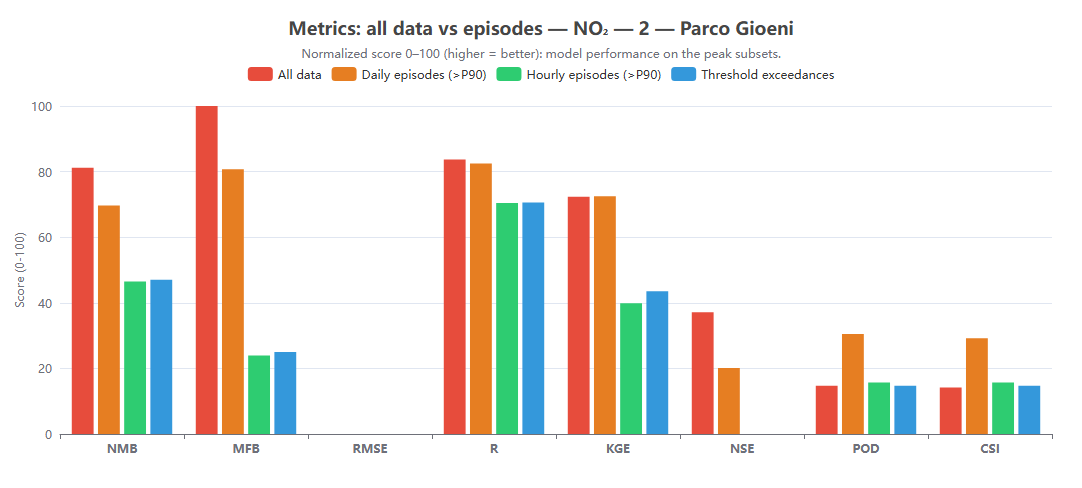
Comparación de métricas: todos los datos frente a episodios
Qué muestra. Para cada métrica (puntuación normalizada 0–100), barras contiguas que comparan el rendimiento del modelo sobre todos los datos con el obtenido solo en los episodios de pico: días con media diaria observada por encima del P90, horas con valor observado por encima del P90 horario y superaciones del umbral normativo (si está definido para el contaminante).
Cómo se construye. A partir de la estratificación «episodios» de los datos de validación: las métricas se recalculan limitando la muestra a los subconjuntos de pico de lo observado (estratos day_p90, hour_p90, exceed) y se normalizan con las mismas reglas de la puntuación.
Por qué lo usamos. Las medias de todo el periodo pueden esconder el comportamiento del modelo justo cuando más importa: los episodios agudos, relevantes para la salud y para los límites normativos (el PM en particular). La comparación revela cuánto se degrada la calidad al pasar de las condiciones ordinarias a los picos.
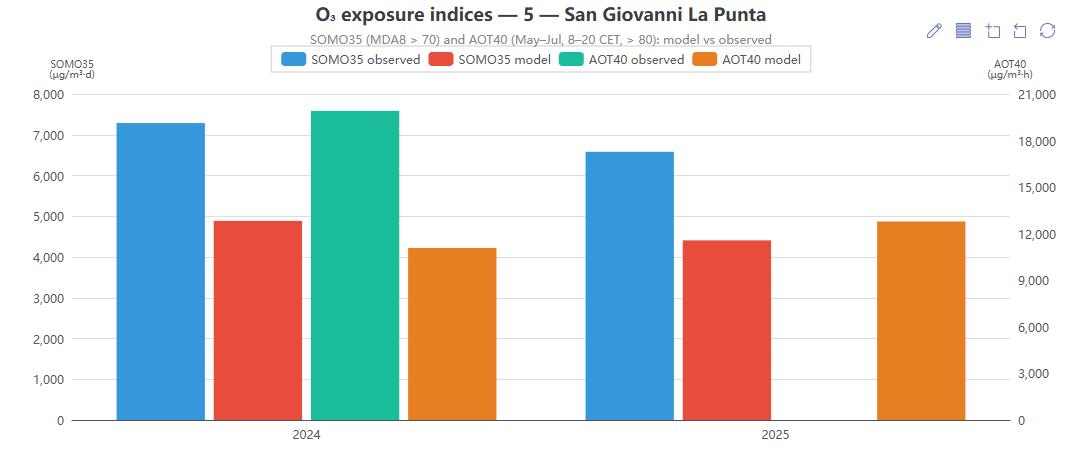
Índices de exposición al O₃ (SOMO35 / AOT40) 🕒 datos del servidor
Qué muestra. Para cada año, los índices normativos de exposición al ozono calculados a partir del modelo y de las medidas: SOMO35 (suma de los excesos del máximo diario de la media móvil de 8 h por encima de 70 µg/m³ — salud) y AOT40 (suma de los excesos horarios por encima de 80 µg/m³ en las horas 8–19 de mayo–julio — vegetación), en dos ejes separados.
Cómo se construye. Cálculo directo en SQL a partir de las series horarias: para el SOMO35 la media móvil de 8 h usa una ventana temporal robusta frente a las horas ausentes (mínimo 6 valores de 8); para el AOT40 se filtran los meses y las horas previstos por la definición. Lo observado, de las medidas de la estación; el modelo, de la celda correspondiente.
Por qué lo usamos. Son los indicadores con los que la normativa (Dir. 2008/50/CE) evalúa el ozono: compararlos modelo-frente-a-medidas dice si el modelo es fiable para los usos regulatorios, no solo en sentido estadístico. Los índices acumulados amplifican los sesgos sistémicos en las colas altas.
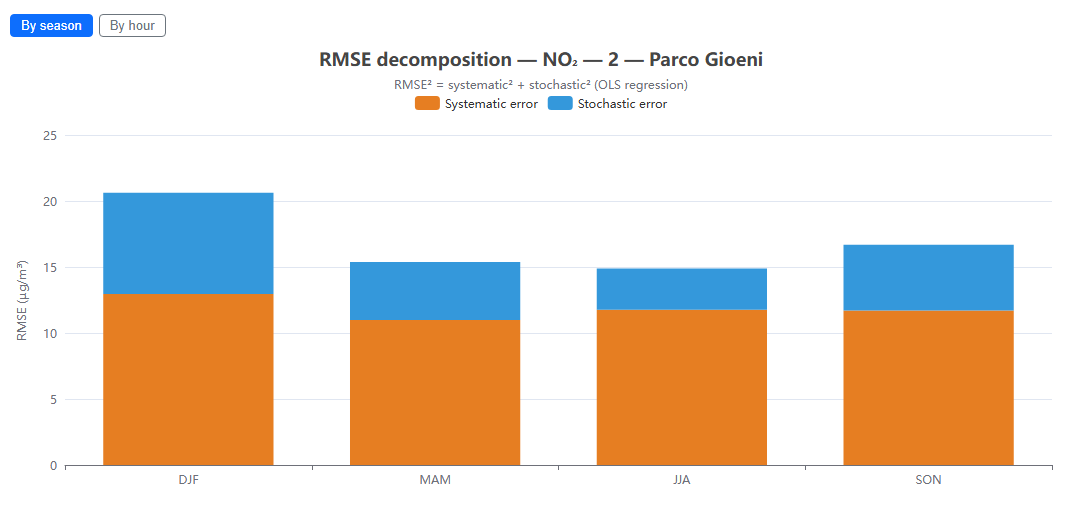
Descomposición del error (sistemático / estocástico)
Qué muestra. El RMSE descompuesto en dos componentes apiladas: la parte sistemática (explicada por la regresión lineal modelo-observado, es decir reducible con una calibración) y la parte estocástica (dispersión residual, no reducible linealmente). Se puede ver por estación del año o por hora del día.
Cómo se construye. Descomposición de Willmott a partir de la regresión OLS mod = a + b·obs: RMSE_s² = ⟨(a+(b−1)·obs)²⟩ y RMSE_u² = RMSE² − RMSE_s². Todo se deriva de las métricas ya calculadas (rmse, pendiente, ordenada en el origen, σ_obs, mb, nmb), sin reprocesar las series.
Por qué lo usamos. Dice qué tipo de error domina: si predomina el sistemático, el modelo se puede mejorar con una corrección del sesgo o una calibración; si predomina el estocástico, el límite está en la física o en la resolución del modelo. La vista por estación del año u hora localiza dónde intervenir.
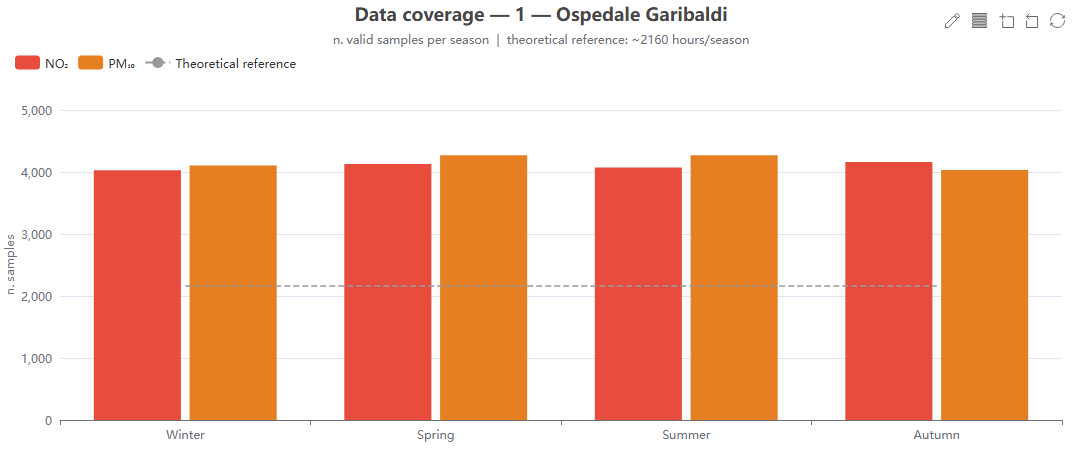
Cobertura de datos (n.º de muestras) por estación del año
Qué muestra. Las barras del número de muestras válidas por estación del año y contaminante, con una línea de referencia teórica (~2160 horas/estación).
Cómo se construye. A partir del campo n_samples de los datos de validación (estratificación «season»).
Por qué lo usamos. La cobertura de los datos condiciona la fiabilidad de todas las métricas: pocas horas válidas hacen frágiles los índices.
Espacial y multivariante
Gráficos que añaden la dimensión espacial o relacionan varias variables a la vez.
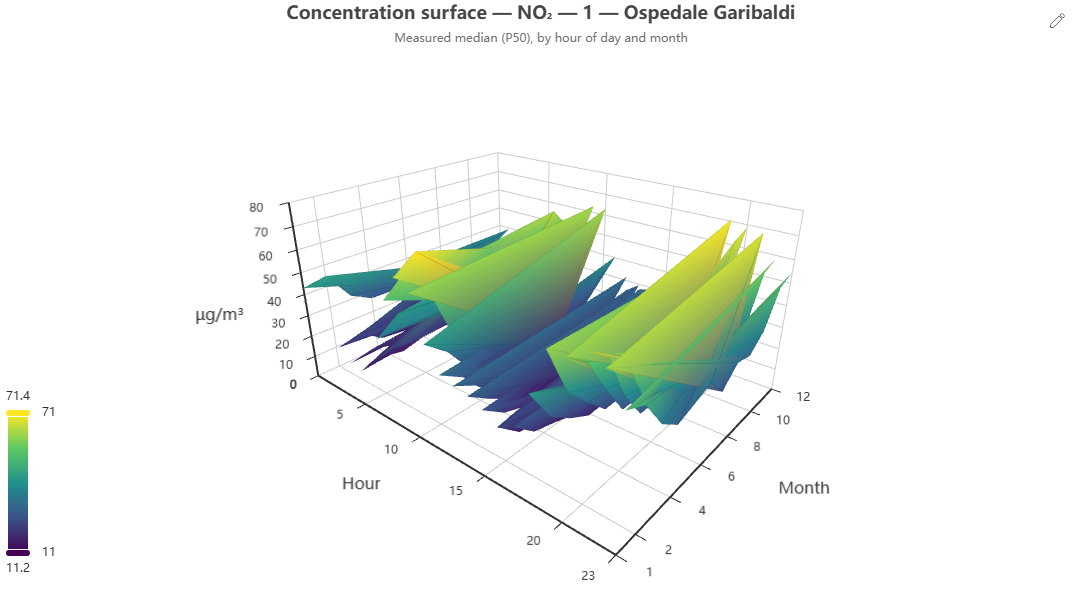
Gráfico de superficie de concentración
Qué muestra. Una superficie 3D de la concentración mediana medida en función de la hora del día y del mes.
Cómo se construye. A partir de los percentiles (estratificación «hour_month», P50 medido), dibujada con ECharts GL.
Por qué lo usamos. Vista tridimensional de conjunto del comportamiento cíclico, útil para captar crestas y valles estacionales.
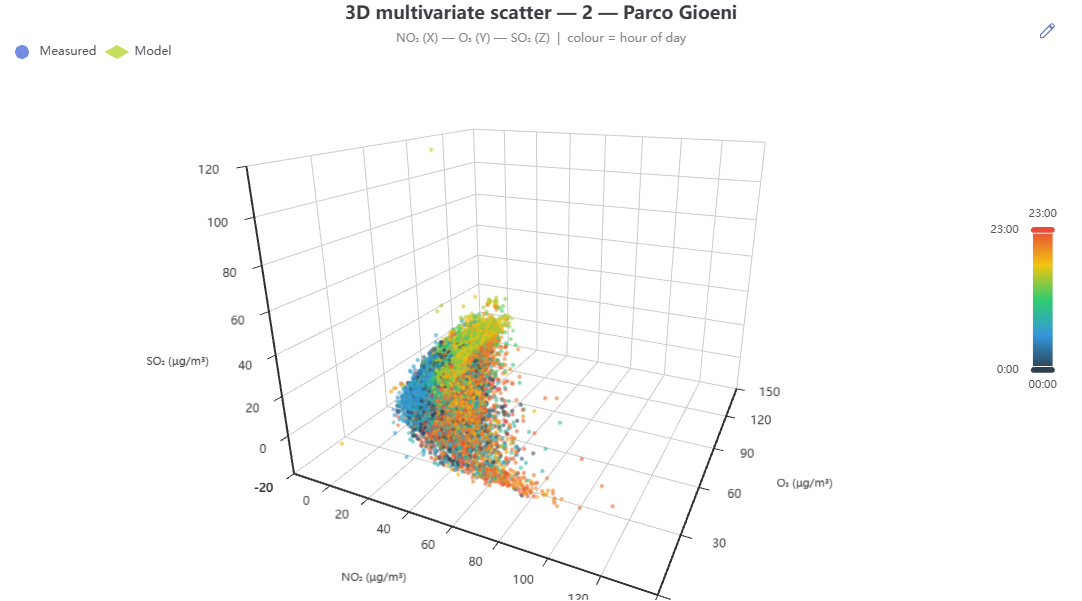
Dispersión 3D multivariante 🕒 datos del servidor
Qué muestra. Una nube 3D de tres contaminantes a la vez (un eje para cada uno), para explorar relaciones multivariantes — por ejemplo la titulación de Leighton entre NO₂, O₃ y PM₂.₅.
Cómo se construye. A partir de scatter3d_data (valores alineados en el tiempo para las tres especies).
Por qué lo usamos. Algunas relaciones químicas emergen solo mirando tres variables juntas, no por pares.
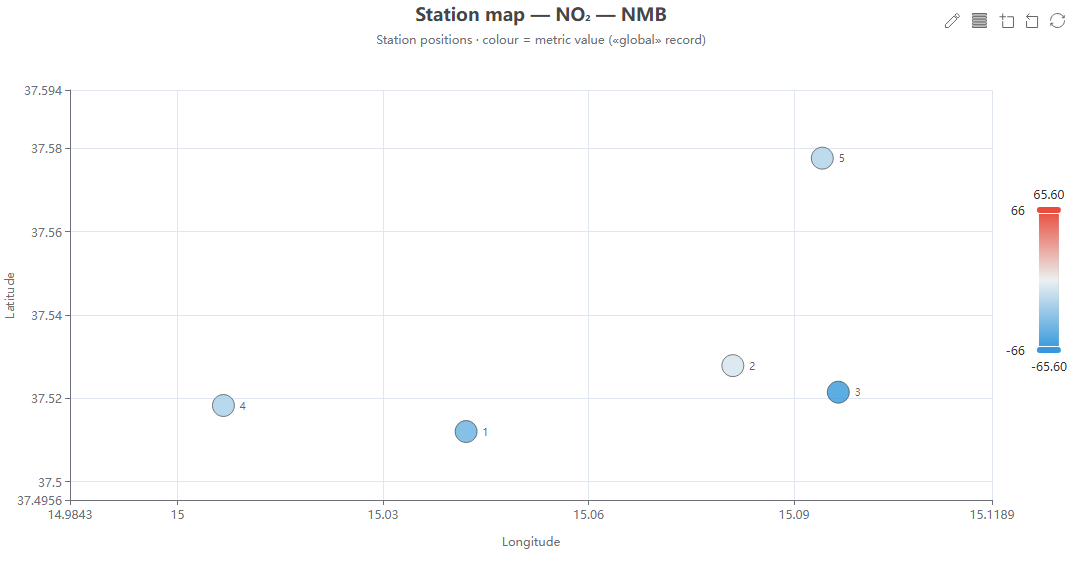
Mapa por estación (métrica)
Qué muestra. Las estaciones situadas por longitud/latitud y coloreadas según la métrica elegida (escala divergente para los sesgos).
Cómo se construye. A partir de los datos de validación (registro «global») y de las coordenadas de las estaciones; sin teselas de base, destaca el patrón espacial relativo.
Por qué lo usamos. Revela estructuras espaciales del error (p. ej. subestimación sistemática en las áreas urbanas) que no se ven en las tablas.
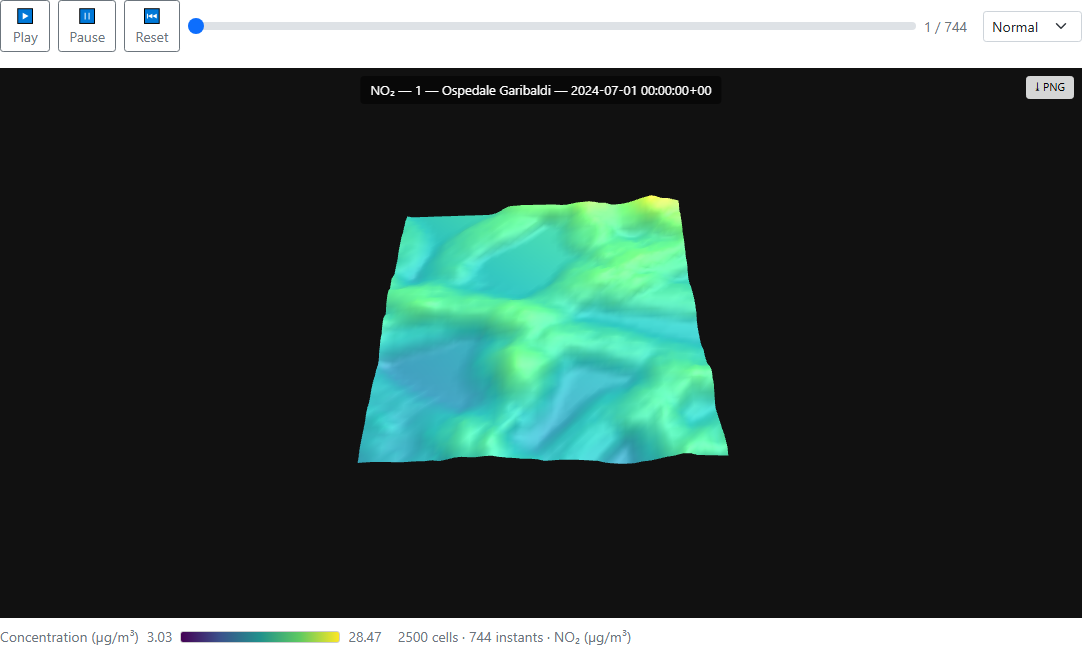
Animación de la retícula de concentración (3D) 🕒🕒 espera larga
Qué muestra. Una animación 3D del campo de concentración del modelo sobre una retícula alrededor de la estación, con un reproductor temporal.
Cómo se construye. A partir de grid_animation_data (celdas y fotogramas cargados por ventanas), dibujada con ECharts GL.
Por qué lo usamos. Muestra la evolución espacio‑temporal de un episodio o de un penacho, imposible de representar con una serie puntual.
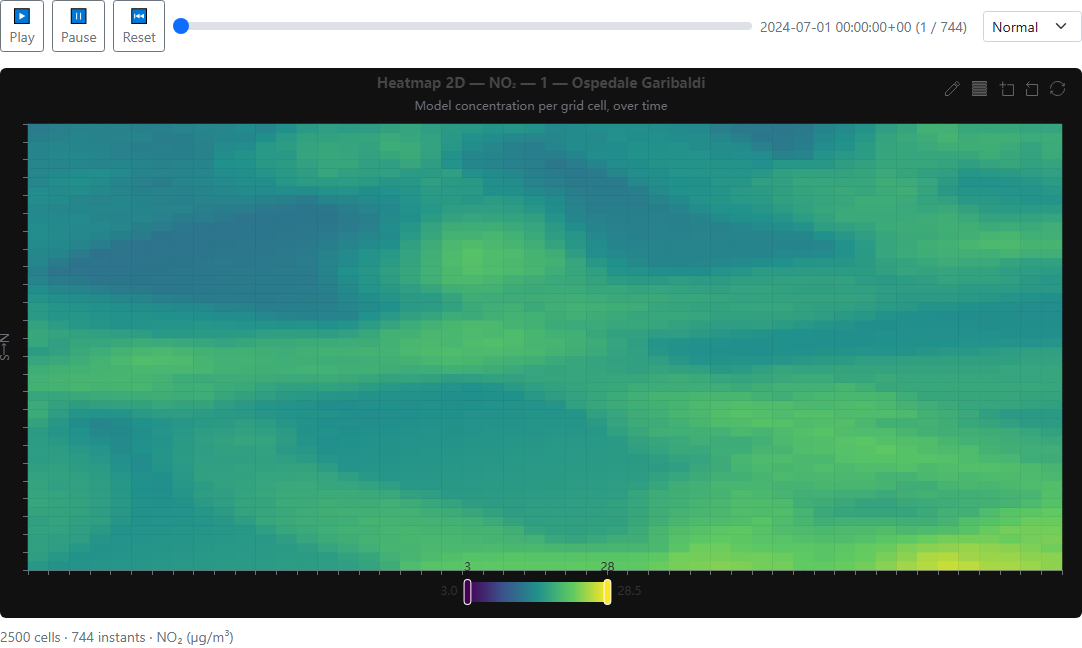
Time-lapse del mapa de calor 2D sobre el mapa 🕒🕒 espera larga
Qué muestra. El mismo campo del modelo como mapa de calor 2D en retícula, animado en el tiempo con reproductor.
Cómo se construye. A partir de grid_animation_data; las celdas se indexan por longitud y latitud.
Por qué lo usamos. Lectura plana e inmediata de la evolución temporal, complementaria del dibujo 3D.